Tavily
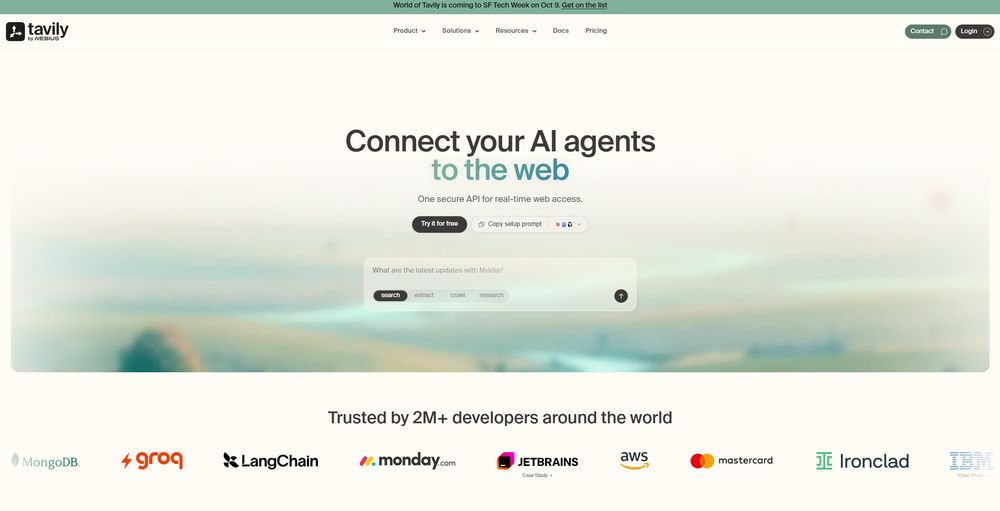
Tavily 是面向 AI Agent 和大语言模型的 Web 数据访问平台,通过 API 提供实时网页搜索、内容提取、网站抓取、地图发现和深度研究等能力,帮助开发者为 AI 应用接入实时互联网信息。
详细介绍
Tavily 是一个面向 AI 应用和 AI Agent 的实时 Web 数据访问平台,主要通过 API 为大语言模型、RAG(检索增强生成)系统和智能体提供联网搜索、网页内容提取、网站抓取、站点地图发现以及深度研究等能力。Tavily 官方将其定位为 AI Agent 的“Web access layer”,帮助开发者获取实时网页信息,并将内容整理成适合模型处理的结构化上下文。
核心功能
Search(网页搜索)
Tavily Search API 用于从互联网检索与问题相关的实时信息,并对搜索结果进行相关性排序和内容处理。搜索支持 Basic 和 Advanced 等模式,其中 Advanced Search 会提供更深入、更相关的内容片段,并支持通过 chunks_per_source 控制每个来源返回的内容块数量。
Extract(网页内容提取)
Extract API 可以从指定 URL 获取干净、结构化的网页内容,并以 Markdown 等格式返回,适合将网页资料进一步交给 LLM 或其他 AI 应用处理。
Crawl(网站抓取)
Crawl API 可以从指定网站入口开始,按照链接关系抓取多个页面,同时支持设置抓取深度、广度、页面数量、路径和域名等参数,适用于网站知识库构建、文档收集和 RAG 数据准备等场景。
Map(网站地图发现)
Map API 用于发现一个网站中的 URL 和页面结构,可以根据指定网站和抓取参数返回页面链接,适合在进一步抓取内容前快速了解网站结构。
Research(深度研究)
Research API 面向更复杂的研究型任务,可以根据输入问题进行多步骤的网络研究,并支持自定义输出结构,例如要求返回特定字段,还支持编号引用格式,适合构建 AI 深度研究和自动化信息分析应用。
适用场景
Tavily 主要面向开发者,而不是传统意义上的普通 AI 聊天搜索工具。它适合用于 AI Agent 联网搜索、RAG 知识检索、实时信息获取、研究助手、企业内部智能应用以及需要动态 Web 数据的 AI 工作流。官方目前提供 Python 和 JavaScript SDK,也可以直接通过 HTTP API 调用。
Tavily 还提供面向 Agent 的开发支持,并已与 OpenAI、Anthropic、Groq 等模型生态以及 AWS、IBM、Microsoft Azure、Databricks、LangChain 等平台建立集成或合作。官方目前称其已服务超过 200 万开发者,平台每月处理超过 3 亿次请求。这些属于 Tavily 官方公布的数据。
价格
目前 Tavily 提供免费方案,注册后每月可获得 1,000 API Credits,无需绑定信用卡;此外还有按量付费方案,当前 Pay As You Go 价格为 $0.008 / credit,Project 方案提供 4,000 API Credits / 月,企业方案则采用定制化价格和额度。不同 API 操作消耗的 Credits 不同,更高级或更大规模的请求通常会消耗更多额度。官方还提供学生免费使用计划。
总结
Tavily 可以理解为一个专门为 AI Agent 和大语言模型设计的联网数据基础设施。与面向普通用户的搜索引擎不同,它的重点是把实时互联网中的搜索结果、网页内容和研究信息转化成适合 AI 模型直接使用的数据,让开发者能够较方便地为 AI 应用加入实时 Web 检索和研究能力。
网站预览